Bloquer l'entraînement des IA sans disparaître de leurs réponses, c'est possible. Les robots à connaître, un robots.txt type, et ce que vaut vraiment le fichier llms.txt.
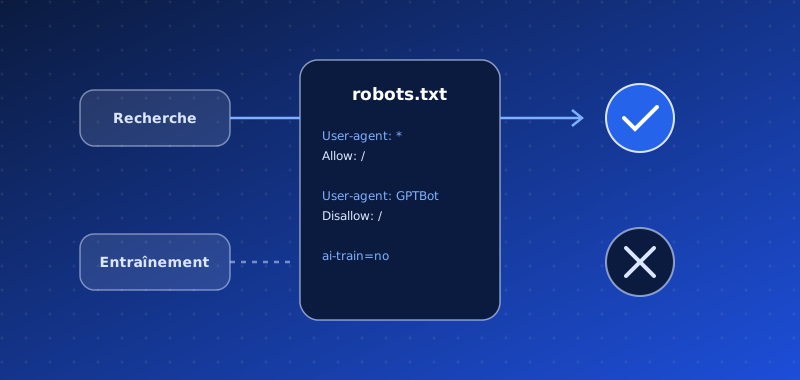
En bref : chaque grand acteur de l'IA utilise plusieurs robots. Certains collectent des pages pour entraîner des modèles, d'autres pour répondre aux questions des utilisateurs et citer leurs sources. Vous pouvez refuser les premiers et accepter les seconds dans votre fichier robots.txt. Bloquer « toutes les IA » d'un coup vous fait aussi disparaître des réponses de ChatGPT ou de Claude.
Trois types de robots
Chez OpenAI comme chez Anthropic, on retrouve la même organisation :
un robot d'entraînement, qui collecte des contenus pour entraîner les futurs modèles ;
un robot de recherche, qui indexe les pages pour pouvoir les citer dans les réponses ;
un agent utilisateur, qui va lire une page précise quand un utilisateur le demande dans la conversation.
Les noms à connaître
OpenAI (ChatGPT)
GPTBot : entraînement des modèles.
OAI-SearchBot : recherche dans ChatGPT. Le bloquer vous retire des réponses de ChatGPT Search.
ChatGPT-User : lecture d'une page à la demande d'un utilisateur.
Anthropic (Claude)
ClaudeBot : entraînement des modèles.
Claude-SearchBot : recherche. Le bloquer réduit votre visibilité dans les réponses de Claude.
Claude-User : lecture à la demande d'un utilisateur.
Perplexity
PerplexityBot : indexation pour les réponses de Perplexity.
Perplexity-User : lecture à la demande.
Google
Googlebot : la recherche Google, y compris les Aperçus IA et le Mode IA. Le bloquer, c'est disparaître de Google.
Google-Extended : ce n'est pas un robot à part, mais un jeton qui indique si vos contenus peuvent servir à entraîner et alimenter Gemini. Selon Google, il n'a pas d'effet sur votre présence dans la recherche Google.
Autres robots d'entraînement fréquents : CCBot (Common Crawl, base de données utilisée pour entraîner de nombreux modèles), Applebot-Extended, Meta-ExternalAgent, Bytespider.
Attention : chaque nom doit avoir sa propre règle. Bloquer ClaudeBot ne bloque pas Claude-SearchBot, et inversement.
Un robots.txt type : présent dans les réponses, absent de l'entraînement
C'est la configuration que nous utilisons sur Trocly :
Les robots de recherche et les agents utilisateurs (OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot…) restent couverts par le premier groupe et peuvent donc lire le site.
La ligne Content-Signal vient de la politique Content Signals proposée par Cloudflare en 2025. Elle exprime vos préférences en une phrase : recherche autorisée, utilisation pour générer une réponse autorisée, entraînement refusé. Tous les robots ne la lisent pas encore ; elle ne remplace donc pas les règles par robot.
Les limites à connaître
Le robots.txt est une convention, pas une serrure. Les grands acteurs déclarent le respecter ; certains robots moins scrupuleux l'ignorent. Pour bloquer réellement, il faut agir au niveau du serveur ou du CDN.
Les agents utilisateurs sont un cas à part. Quand un humain demande à ChatGPT de lire votre page, certains éditeurs considèrent qu'il s'agit d'une visite à la demande et pas d'une exploration automatique. Le comportement vis-à-vis du robots.txt peut différer.
Votre CDN peut décider à votre place. Plusieurs hébergeurs et CDN proposent de bloquer les robots d'IA en un clic, parfois activé par défaut. Vérifiez ce réglage : il peut annuler votre robots.txt.
Bloquer l'entraînement n'efface pas le passé. Les contenus déjà collectés ne sont pas retirés des modèles existants.
Et le fichier llms.txt ?
Le fichier llms.txt est une proposition de 2024 : un fichier Markdown placé à la racine du site, qui présente l'entreprise et liste ses pages importantes avec une courte description. L'idée : offrir aux modèles de langage un résumé propre plutôt que des pages HTML chargées de menus et de scripts.
Ce qu'il faut en savoir :
Google ne l'utilise pas pour la recherche ni pour ses Aperçus IA.
Certains outils (assistants de code, agents, moteurs de recherche IA) le lisent, sans que son effet sur les citations soit démontré.
Il est facile à produire, surtout s'il est généré automatiquement à partir de votre plan du site.
Notre avis : c'est un bonus peu coûteux, pas une priorité. Si vous en publiez un, générez-le automatiquement pour qu'il reste à jour. Un llms.txt avec des informations périmées fait plus de mal que de bien. Le site d'Elite Coding publie le sien sur /llms.txt, régénéré à chaque nouvel article.
La vérification en cinq minutes
Ouvrez https://votre-site.fr/robots.txt et cherchez les noms listés plus haut.
Vérifiez dans le tableau de bord de votre CDN ou hébergeur s'il existe un blocage des robots d'IA.
Consultez vos journaux de serveur : quels robots d'IA passent, et reçoivent-ils des réponses 200 ou 403 ?
Décidez, robot par robot, de ce que vous acceptez.
Notez la date et la raison de votre choix : la liste des robots évolue vite, vous y reviendrez.
Trocly, le site de petites annonces que nous éditons, sert de terrain d'essai : données publiques, pages qui se citent, robots d'IA triés un par un. Ce que nous avons mis en place.
Un agent IA ne se contente pas de répondre : il agit dans vos outils. Comment choisir un premier cas d'usage, fixer les garde-fous et mesurer le résultat avant d'aller plus loin.
Structure, sources, chiffres, données structurées, réputation : les actions concrètes qui augmentent les chances qu'une IA reprenne votre contenu, et celles qui ne servent à rien.
Lire l'article →
Premier échange offert
Parlons de votre projet.
30 minutes pour comprendre votre besoin et vous dire franchement ce qui est faisable.